


Satu studi dari Ahrefs, awal 2025, menganalisis hampir sejuta halaman baru di internet. Hasilnya benar-benar bikin kaget. Ternyata lebih dari 74% halaman online ditulis dengan bantuan AI (Ahrefs, 2025).
Internet yang dulu jadi kumpulan ide liar, perdebatan hangat, dan tulisan penuh emosi manusia, kini pelan-pelan dipenuhi kalimat-kalimat generik buatan mesin. Dan ini semua sudah mengubah hidup kita.
Lihat saja di berbagai sekolah, para siswa semakin sering menyerahkan esai yang sebagian besar ditulis oleh AI.
Banyak dosen merasa kesulitan menilai, mana ide yang orisinal, dan mana yang buatan mesin. Jika ini terus dibiarkan, maka kemampuan generasi muda kita untuk berpikir kritis bisa hilang, digantikan oleh tombol copy-paste.
Ranah politik pun juga kena dampak. Para politisi memproduksi ribuan konten kampanye dengan cepat berkat bantuan AI. Bahayanya antara lain, AI bisa juga dipakai untuk menyamar sebagai “suara rakyat biasa” dan berusaha terus menggiring opini publik.
Jadi, AI Itu Belajar Dari Mana
Kalau ditanya “dari mana AI dapat kemampuan?”, jawabannya sederhana: dari data. AI bekerja memproses miliaran kata, gambar, suara. Dari sana, dia belajar pola —bagaimana kata saling muncul, bagaimana kalimat terbentuk, bagaimana informasi dirangkai, dst. Proses ini disebut “training”.
Memang manusia ikut campur di tahap penting ini yaitu memberi “feedback” dengan pola Reinforcement Learning with Human Feedback (RLHF), yaitu jawaban AI dinilai oleh manusia. Kalau benar, diberi “hadiah”. Kalau ngawur, diberi “hukuman”. Dari sini, lama-lama, AI belajar menyesuaikan diri dengan preferensi manusia.
Tapi memang tetap ada problem yang muncul, yaitu ketika si manusia nya juga salah memberikan feedback. Apalagi penilaian itu bisa subjektif juga. Bahkan seorang kurator terbaik sekalipun pun tetap aja bisa bias. Jadi sebenarnya AI tidak pernah murni benar-benar netral. Dia selalu berada dalam “bayangan dari data yang dimakan” dan “bias dari tangan yang melatihnya”.
Lingkaran Setan: Model Collapse
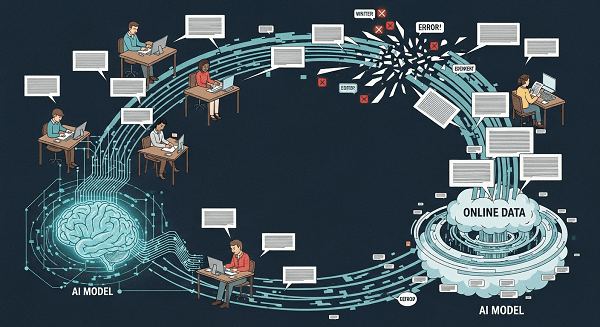
Masalah makin pelik ketika AI dilatih lagi dari konten yang sebelumnya juga dibuat oleh AI. Prosesnya kurang lebih seperti ini. AI mengambil data dan belajar dari data yang ada di internet. Lalu manusia memproduksi konten menggunakan AI. Akhirnya internet semakin penuh dengan konten buatan AI, seperti yang disinyalir penelitian Ahref diatas. Terus AI ngambil lagi data tersebut. Produksi lagi. Begitu seterusnya. Muter kayak lingkaran setan.
Akibat proses seperti ini, akhirnya, variasi hilang, bahasa makin kaku, informasi jadi tambah miskin nuansa. Fenomena ini dikenal sebagai model collapse (Shumailov et al., 2023)
Analogi gampangnya: bayangkan memfotokopi fotokopi, lalu difotokopi lagi, dan seterusnya. Hasil akhirnya makin kabur, makin jelek. Sama halnya dengan teks—kalau internet penuh tulisan generik hasil mesin, lalu AI berikutnya belajar dari tumpukan itu, hasilnya makin seragam, makin miskin, dan makin jauh dari pengalaman nyata manusia. Dan kita sudah mulai melihat tanda-tandanya.
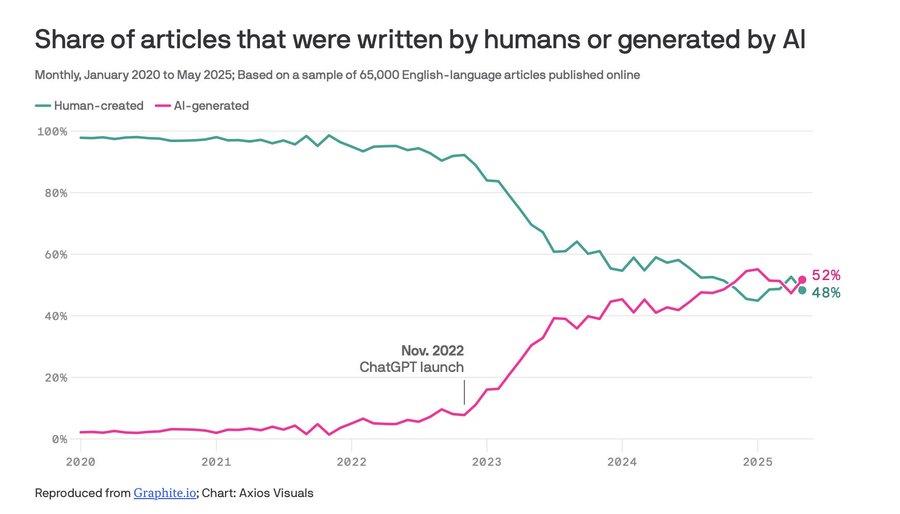
Tak heran, jika survei Pew Research 2024, menemukan bahwa lebih dari separuh responden di Amerika menyebut internet sekarang terasa “kurang otentik” dibanding lima tahun lalu dan mayoritas yakin bahwa konten AI adalah penyebab utamanya.
Krisis Kepercayaan Publik
Begitu pola ini meluas, konsekuensi terbesarnya adalah hilangnya kepercayaan publik. Berita pun mulai dipandang sinis. Siapa yang bisa menjamin berita tersebut ditulis oleh manusia?
Survei yang dilakukan New York Post pada 2025 menemukan bahwa hanya 41% orang yang masih percaya konten online itu akurat dan manusiawi. Sementara 82% mendukung aturan agar konten-konten buatan AI harus diberi label jelas sebagai buatan AI (NYPost, 2025)
Masalahnya, “kebohongan” ini terus merembes pada hal sehari-hari. Katakanlah kita mau beli produk, lalu mengecek ulasan atau testimoni dari “pembeli lain”. Ternyata banyak ulasan-ulasan itu ditulis oleh AI. Dari survei terbaru, hanya 30% konsumen yang bisa membedakan mana review yang dibuat oleh manusia dan mana review buatan AI (NYPost, 2025). Dan angka itu akan semakin besar dari hari ke hari.
Maka bisa ditebak, kepercayaan konsumen bisa runtuh. Banyak orang akhirnya akan ragu dengan setiap review atau testimoni yang ada.
Kalau ulasan belanja saja sudah diragukan, apalagi berita politik atau jurnal akademik? Ini menjadi bukan lagi sekadar urusan teknis. Ini sudah masuk persoalan eksistensial: siapa yang sebenarnya sedang bicara dengan kita—manusia atau mesin?
Menuju AI Berbasis Pengetahuan
Untungnya, masih ada pendekatan baru yang mungkin sedikit lebih menjanjikan: knowledge-driven AI, yaitu AI yang berbasis pengetahuan.
Salah satunya lewat neuro-symbolic AI yaitu gabungan antara deep learning dan logika formal. AlphaGeometry dari Google DeepMind berhasil menyelesaikan soal geometri olimpiade dengan logika, bukan sekadar menebak berdasarkan pola kata (Business Insider, 2024)
Ada juga RAG (Retrieval-Augmented Generation). Di sini, AI tidak hanya mengandalkan ingatan internal, tapi mencari ulang data dari berbagai sumber yang terpercaya, seperti jurnal akademik atau dokumen hukum. Mirip pakar yang buka arsip sebelum menjawab.
Juga ada Knowledge Graphs. Dengan ini, AI bisa memahami hubungan antar konsep, bukan sekadar kata demi kata. Misalnya, AI medis bisa menarik data dari basis Alzheimer untuk membantu riset genetik —lebih dalam, lebih bermakna (arXiv, 2024)
Kalau pendekatan ini berkembang, AI di masa depan bisa lebih seperti “asisten riset digital” daripada sekadar “mesin penebak kata”.
Arsip Pengetahuan atau Lautan Slop
Ya, saat ini kita memang sedang berada di titik genting. Apakah internet lima tahun lagi akan jadi hanya “arsip pengetahuan manusia”, atau sekadar lautan teks hambar yang disemburkan algoritma?
Kalau dibiarkan, AI hanya akan mengulang dirinya sendiri, dan internet akan kehilangan otentisitasnya. Tapi kalau diarahkan dengan tepat—dengan kurasi, regulasi, dan desain teknologi yang bijak—AI bisa menjadi penopang pengetahuan, bukan penggali kuburnya.
Di sinilah peran intelektual, penulis, dan konten kreator jadi krusial. Yang kita butuhkan bukan sekadar orang yang bisa mengetik, melainkan orang yang benar-benar paham apa yang ia tulis—dan punya otoritas untuk bicara soal itu.
Pesan akhirnya sederhana saja, tapi cukup penting, yaitu mari kita lebih kritis membaca atau menonton konten apapun—baik berita, video, artikel, ataupun bahkan tulisan ini.
Dengan paham dari mana AI belajar, dan dengan menyadari bahwa data tidak sama dengan pengetahuan, kita bisa lebih waspada. Jangan telan bulat-bulat setiap teks yang mampir di layar kita. Biarlah mesin menyalin kata, tapi manusia yang menjaga makna.
Pilihan ada di kita: membiarkan algoritma menulis masa depan kita tanpa arah, atau ayo segera kembali mengambil kendali untuk memastikan mesin tetap belajar dari manusia—bukan hanya dari bayangan dirinya sendiri.
***
BAHAN BACAAN
Ahrefs. (2025). What Percentage of New Content Is AI-Generated? Diakses dari: https://ahrefs.com/blog/what-percentage-of-new-content-is-ai-generated
Shumailov, I., et al. (2023). The Curse of Recursion: Training on Generated Data Makes Models Forget. arXiv preprint. Diakses dari: https://arxiv.org/abs/2305.17493
Pew Research Center. (2024). Public Attitudes Toward Artificial Intelligence and Online Trust. (laporan survei).
New York Post. (2025). Majority of Americans Trust What’s Online Less Than Ever Before. Diakses dari: https://nypost.com/2025/04/26/lifestyle/majority-of-americans-trust-whats-online-less-than-ever-before
Business Insider. (2024). The Debate Over Synthetic Data in AI Training. Diakses dari: https://www.businessinsider.com/ai-synthetic-data-industry-debate-over-fake-2024-8
ArXiv. (2024). Knowledge Graphs in AI Applications: Bridging Symbolic and Neural Approaches. Diakses dari: https://arxiv.org/abs/2404.01413




 Follow Us